- همبستگی بین جفت ارز در دلار FX Straight/Cross yen
- نحوه ساخت یک سبد سرمایه گذاری
- آموزش تبادل Kucoin و بررسی ویژگی های Kucoin
- قیمت بیت کوین ممکن است 20 کیلو دلار در CPI ایالات متحده در میان فقدان فرود نرم - معامله گر باشد
- OctaFX: 5 روشی که معامله گران طعمه احساسات خود می شوند و اشتباه می کنند
- ارز شیبا چیست؟
- نحوه تجارت بیت کوین در ژوئن 2023
- این سه موردی است که شما باید قبل از سرمایه گذاری در cryptocurrency بدانید
- چه زمانی کسب و کار خود را محور کنم و چگونه بدانم که زمان مناسبی برای تغییر است؟
- به طور فوری به مربی تجارت آنلاین سهام در Begusarai نیاز دارید (شناسه شغل: 13382252)

آخرین مطالب
امکانات وب


ساخت مدل تجزیه و تحلیل احساسات خود ممکن است دلهره آور به نظر برسد. این راهنما شما را از طریق مراحل شروع می کند.
خوانندگان مانند شما به حمایت از MUO کمک می کنند. وقتی با استفاده از پیوندها در سایت ما خرید می کنید ، ممکن است یک کمیسیون وابسته کسب کنیم. بیشتر بخوانید
تجزیه و تحلیل احساسات یک تکنیک پردازش زبان طبیعی (NLP) است که نگرش پشت یک متن را مشخص می کند. همچنین به عنوان معدن نظر شناخته می شود. هدف تجزیه و تحلیل احساسات مشخص کردن اینکه آیا یک متن خاص دارای احساسات مثبت ، منفی یا خنثی است یا خیر. این کار به طور گسترده ای توسط مشاغل برای طبقه بندی خودکار احساسات در بررسی مشتری استفاده می شود. تجزیه و تحلیل حجم زیادی از بررسی ها به به دست آوردن بینش ارزشمند در مورد ترجیحات مشتریان کمک می کند.
تنظیم محیط خود
برای پیگیری باید با اصول اولیه آشنا باشید. به Google Colab بروید یا نوت بوک Jupyter را باز کنید. سپس یک نوت بوک جدید ایجاد کنید. دستور زیر را برای نصب کتابخانه های مورد نیاز در محیط خود اجرا کنید.
کد منبع کامل این پروژه در این مخزن GitHub موجود است.
! نصب PIP Tensorflow Scikit-Lea Pandas numpy Pickle5
برای دستکاری در مجموعه داده از کتابخانه Numpy و Pandas استفاده خواهید کرد. Tensorflow برای ایجاد و آموزش مدل یادگیری ماشین. Scikit-Lea برای تقسیم مجموعه داده ها به مجموعه های آموزش و آزمایش. در آخر ، از Perkle5 برای سریال سازی و ذخیره شی Tokenizer استفاده خواهید کرد.
وارد کردن کتابخانه های مورد نیاز
کتابخانه های لازم را که از آنها استفاده خواهید کرد برای پیش پردازش داده ها و ایجاد مدل وارد کنید.
وارد كردناعماقasNPوارد كردنپانداasPDوارد كردنتانسور پرasTFاز جانبsklea. model_selectionوارد كردنtrain_test_splitاز جانبSklea. Metricsوارد كردندقت_کوراز جانبtensorflow. keras. preprocessing. textوارد كردننشان دهندهاز جانبtensorflow. keras. preprocessing. Equealceوارد كردنpad_equeencesاز جانبtensorflow. keras. modelsوارد كردنمتوالیاز جانبtensorflow. keras. layersوارد كردنتعبیه ، Conv1d ، GlobalMaxPooling1D ، متراکم ، ترک تحصیلوارد كردنترشی 5asترشی بعداً از کلاس هایی که از ماژول ها وارد می کنید بعداً در کد استفاده خواهید کرد.
بارگیری مجموعه داده
در اینجا ، برای ساختن مدل تجزیه و تحلیل احساسات ، از مجموعه داده های بررسی هتل از Kaggle استفاده می کنید.
df = pd. read_csv ('/content/tripadvisor_hotel_reviews. csv') چاپ (df. head ()) مجموعه داده ها را بارگیری کنید و پنج ردیف اول آن را چاپ کنید. چاپ پنج ردیف اول به شما در بررسی نام ستون مجموعه داده های خود کمک می کند. این امر در هنگام پردازش مجموعه داده بسیار مهم خواهد بود.
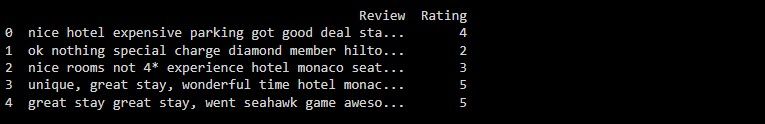
مجموعه داده های بررسی هتل Advisor Advisor دارای یک ستون فهرست ، یک ستون بررسی و یک ستون رتبه بندی است.
پیش پردازش داده ها
ستون های بررسی و رتبه بندی را از مجموعه داده انتخاب کنید. یک ستون جدید بر اساس ستون رتبه بندی ایجاد کنید و آن را احساسات کنید. اگر امتیاز بیشتر از 3 است ، احساسات را مثبت نشان دهید. اگر رتبه کمتر از 3 است ، آن را منفی کنید. اگر رتبه بندی دقیقاً 3 است ، آن را خنثی کنید.
فقط ستون های بررسی و احساسات را از مجموعه داده انتخاب کنید. ردیف ها را به طور تصادفی تغییر دهید و شاخص قاب داده را مجدداً تنظیم کنید. جابجایی و تنظیم مجدد اطمینان حاصل می کند که داده ها به طور تصادفی توزیع می شوند ، که برای آموزش و آزمایش مناسب مدل ضروری است.
df = df [['مرور', "رتبه بندی"]] DF ['احساسات'] = DF ["رتبه بندی"]. درخواست دادن(لامبداایکس:"مثبت" if x> 3 دیگر 'منفی' ifایکس<3 دیگر 'خنثی') df = df [['مرور', 'احساسات']] df = df. sample (frac =1) . reset_index (drop =درست است، واقعی) متن بررسی را به دنباله ای از اعداد صحیح با استفاده از Tokenizer تبدیل کنید. این یک فرهنگ لغت از کلمات منحصر به فرد موجود در متن بررسی ایجاد می کند و هر کلمه را به یک مقدار عدد صحیح منحصر به فرد نقشه می کند. برای اطمینان از اینکه تمام توالی های مرور از طول یکسان برخوردار هستند ، از عملکرد Pad_equeences از Keras استفاده کنید.
tokenizer = tokenizer (num_words =5000، oov_token ='') tokenizer. fit_on_texts (df ['مرور']) word_index = tokenizer. word_index توالی = tokenizer. texts_to_toctions (df ['مرور']) padded_مان = pad_مان (توالی ، maxlen =100، کوتاه کردن ='پست') برچسب های احساسات را به رمزگذاری یک داغ تبدیل کنید.
sentiment_labels = pd. get_dummies (df ['احساسات']). ارزش هایرمزگذاری یک داغ نشان دهنده داده های طبقه بندی شده در فرمی است که کار با مدل های شما آسان تر است.
تقسیم مجموعه داده ها به مجموعه های آموزش و آزمایش
از Scikit-Lea استفاده کنید تا به طور تصادفی مجموعه داده ها را به مجموعه های آموزش و آزمایش تقسیم کنید. شما از مجموعه آموزش برای آموزش مدل برای طبقه بندی احساسات بررسی ها استفاده خواهید کرد. و شما از مجموعه آزمون برای دسترسی به مدل خوب در طبقه بندی بررسی های جدید غیب استفاده خواهید کرد.
دوره ی فارکس...
ما را در سایت دوره ی فارکس دنبال می کنید
برچسب :
نویسنده : پرویز حبّی
بازدید : <-PostHit->
خبرنامه
